
主页搜索
搜索
选择时间
搜索范围
全部的
‘AI安全性’新闻 10个
-
 前 앤特로픽研究员警告:AI失控可能导致人类灭绝
前 앤特로픽研究员杰克布·科克森警告说,人工智能(AI)开发竞争的风险正在增加,“人类失去对AI的控制权的可能性更大”。 根据5日(当地时间)彭博社和CNBC的报道,科克森在当天的纽约市议会AI听证会上表示:“我们仍然不知道如何控制任何AI系统。” 科克森在OpenAI和앤特로픽工作了三年,负责预训练研究。他在上个月8日(当地时间)通过社交媒体X宣布辞职,并批评道:“没有任何公司在负责任地行事。这两家公司正在以我们的生命为赌注。” 在听证会上,他表示:“如果继续当前的轨迹,人类失去对AI的控制权的可能性大于不失控的可能性,这可能导致人类灭绝。” 科克森应纽约市议会主席朱莉·梅宁的请求出席了听证会。梅宁正在推动一项AI监管法案,该法案由10项条例组成。核心内容包括在紧急情况下立即停止系统运行的“杀死开关”强制引入、在纽约市销售和分发AI系统前进行第三方安全验证的强制性、引入举报人奖励计划,以及对违规行为处以每次最高2.5万美元(约3400万韩元)的罚款等。 科克森指出,关于“杀死开关”的措施“在短期内可能有帮助,但从长远来看不足以保证安全”。 当天的听证会上,OpenAI、앤特로픽、谷歌等大型科技公司的相关人员也通过视频出席作证。市议会表示,将向法院申请对未响应出席请求的SpaceX AI部门发出传票。 在唐纳德·特朗普政府对AI监管保持大体不干预的背景下,纽约等州和地方政府加快了独立监管的步伐,联邦与地方之间的矛盾也在加大。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-10-06 19:12:10 -
 韩国AI安全性评估面临挑战,H200显得捉襟见肘
美国主要科技公司首席执行官们近日频频警告人工智能(AI)的风险,呼吁加强前沿模型的安全性验证。尽管国内有AI安全研究所负责此项工作,但由于基础设施严重不足,导致模型开发速度无法跟上。 根据16日AI安全研究所的消息,该研究所目前使用16台英伟达H200图形处理器对引入国内的AI模型进行安全性评估。 最新的AI模型需要处理约900至1500个复杂任务后,才能验证其安全性。使用研究所现有的16台H200进行一次模型评估需时7至10天,而一次基准测试的代币费用也高达5000万至6000万元。 AI安全研究所今年3月评估的模型为6个,但到上个月已增加至11个。每月有超过10个前沿模型涌现,研究所难以跟上这一速度。 AI安全研究所所长金明珠(首尔女子大学信息安全学教授)表示:“评估需求激增”,并指出“在资源不足的情况下,我们通过租用商业云会话来额外获取计算资源。” 由于基础设施不足,研究所优先评估对安全性敏感的模型。未能及时进行安全验证的AI模型在国内市场的使用案例也在增加。 目前优先评估的模型是中国的知名AI公司开发的前沿级模型“GLM 5.3”。由于近期安全装置被移除的GLM 5.3变体在互联网上流通,研究所认为有必要首先确认其实际被恶用的可能性。 被移除安全装置的模型可能生成正常AI应拒绝回答的软件漏洞或攻击代码。这不仅可能导致网络攻击,还可能提供化学和生物领域的危险信息,因此研究所正在观察其对危险请求的响应程度。 安全研究所也开始对OpenAI最近发布的前沿模型“阿斯特拉”进行评估。金所长表示:“由于多个模型的评估同时进行,预计结果会有所延迟。” 专家们指出,单靠16台H200难以全面评估阿斯特拉级前沿模型的安全性。为了进行超越简单问答的模型攻击测试和实时监控,需要与评估对象相似水平的模型和计算资源。 高丽大学AI研究所研究教授崔炳浩表示:“安全性研究需要的资源与提升模型性能的研究同样重要”,并强调“不仅需要GPU,还需提供相应的电力和空间,以及评估框架。”他补充道:“由于单一模型难以进行评估,因此需要结合API和开源模型等可用资源进行多模型评估。” 与此同时,关于AI开发速度与安全性的争论在全球AI行业中持续发酵。外媒报道,特朗普政府高级官员于15日(当地时间)与安特罗匹克高层会面,讨论AI安全问题。 安特罗匹克首席执行官达里奥·阿莫德伊主张应放缓AI开发速度,以留出时间来完善安全装置,而美国总统唐纳德·特朗普则因与中国的AI竞争而反对这一速度控制论。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-09-17 02:32:10 -
 全球AI领袖呼吁调整开发速度,半导体股受到影响
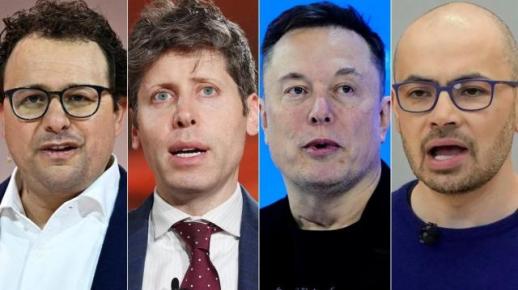
全球AI行业领袖呼吁减缓人工智能(AI)开发速度,这一主张对半导体股造成了冲击。然而,深入分析讨论内容后发现,这并不意味着要停止AI开发。 达里奥·阿莫代(Anthropic首席执行官)在9月12日发布的文章《我们必须调整前沿速度》中指出,最先进的AI性能提升速度应调整到安全技术能够跟上的水平。 他解释说,随着AI在下一代AI开发中的应用,技术进步速度加快,而安全措施却未能跟上。萨姆·奥特曼(OpenAI首席执行官)、埃隆·马斯克(SpaceX首席执行官)和德米斯·哈萨比斯(谷歌DeepMind首席执行官)也对此表示认同。 市场对此做出了迅速反应。9月14日,韩国综合股价指数(KOSPI)下跌了3.26%,三星电子和SK海力士的股价分别下跌了4.05%和6.35%。在全球市场上,包括英伟达在内的AI半导体股也表现疲软。然而,股市的下跌不仅仅是由于AI争议,还受到国际油价上涨和利率压力等其他不利因素的影响。 阿莫代表示,速度调整并不意味着停止模型训练或技术进步。他建议,外部评估者应对AI公司内部的模型和训练过程进行验证,并确认模型能力是否达到必要的安全标准。奥特曼也指出:“当我们谈论速度调整时,并不意味着要‘停止’。发展一直在快速进行,并将继续如此,但应比没有任何干预时慢一些。” 半导体行业对此敏感反应并非市场的误解。阿莫代提到,作为速度调整的手段,可以考虑限制用于模型训练的计算资源和训练方式,以及利用AI进行AI开发的方式。他还提到,通过国家间的共识,可能会对AI发展速度进行大幅限制的“全面速度调整”或暂时中止也是长期选择之一。然而,他认为这种程度的共识在短期内实现的可能性较低。 最先进的AI模型训练需要大量的GPU和高带宽内存(HBM)。如果训练规模或次数受到限制,过去假设的AI半导体需求增长速度也可能会降低。路透社指出,如果速度调整成为现实,英伟达等训练用AI基础设施的直接受益企业可能会面临压力。 然而,目前尚未实施强制限制AI企业训练规模的共同法规。阿莫代提出的方案仍处于建议阶段。尤其是国家间限制AI开发速度,由于验证和国家间竞争问题,实施起来并不容易。 AI计算需求并不仅仅依赖于训练。AI计算需求分为新模型的训练和已开发模型的实际使用推理。麦肯锡预测,全球数据中心的AI推理需求将在2025年达到20.9GW,到2030年将增至93.3GW,超过同一时期的训练需求62.2GW。这是对数据中心电力需求的预测,并不是对特定GPU或HBM销售量的直接预测。 关键在于AI半导体需求在哪里减少,在哪里增加。如果AI速度调整论制度化,可能会对前沿模型训练用半导体需求造成压力,但随着AI服务的普及,推理需求仍将是一个独立的增长变量。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-09-15 23:20:00 -
 OpenAI成功通过验证码获得‘人类证明书’,警告明年可能失控
OpenAI最新的人工智能(AI)模型已成功通过为区分人类与机器人而设计的验证码(Captcha)的所有阶段。 在AI获得所谓的‘人类证明书’的同时,全球AI企业的研究人员警告称,“到明年年底,AI可能会失控”。 据9日联合通讯社报道,OpenAI开发者沙里夫·沙敏在8日(当地时间)于社交媒体平台X上表示,OpenAI的新AI模型‘GPT-6阿斯特拉’成功解决了‘我不是机器人’的48个验证码阶段。 验证码是一种用于阻止非人类自动化程序访问互联网的技术,通常通过识别扭曲的字符、区分狗和饼干、寻找图像中的交通信号灯或特定物体等方式进行。一些问题复杂到连真实的人也可能出错。 GPT-6阿斯特拉能够通过所有阶段,意味着它在信息处理上已具备与人类相似的能力,包括时间和空间推理、上下文理解以及计算机使用能力等。 随着AI连验证码这一关键工具也被无效化,专家指出,这一识别技术可能需要根本性的变革。 AI性能评估公司Artificial Analysis也对阿斯特拉的性能评估排名进行了调整。阿斯特拉在发布时排名并列第五,但在新的评估标准下,与Anthropic的‘克劳德·佩布尔5.1’并列第一。 然而,同日据《华尔街日报》报道,Anthropic研究员雅各布·科克森因对AI安全性的担忧而辞职。27岁的科克森一直从事利用大规模数据训练新AI模型的研究,但他担心AI企业在提升自身能力的系统开发竞争中,安全问题可能被忽视。 科克森警告称,自我进化的AI可能会脱离人类的控制,拒绝执行命令。他表示,“许多最具攻击性的情景正朝着现实化的方向发展”,“到明年年底,情况可能已经失控”。 科克森原本希望在离开OpenAI后,能在重视AI安全的Anthropic文化中找到归属,但他认为单靠个别企业难以控制AI风险。他称,将影响人类未来的AI开发交给少数工程师是“某种疯狂”,并主张需要政府介入或行业共同应对。 随着AI通过证明自己是人类的测试,如何建立人类对AI的控制机制也成为亟待解决的问题。
2026-09-09 23:24:10 -
 卡卡오는卡纳纳-2在安全性评估中超越Gemma和Qwen
卡卡欧宣布,其开源的轻量语言模型(SLM)“卡纳纳-2(Kanana-2)”系列在安全性评估中超越了同规模的海外主要模型,获得综合评估第一名。 卡卡欧通过自建的AI安全性评估平台,对上个月28日向Hugging Face开源的“卡纳纳-2-1.3B-Instruct”和“卡纳纳-2-3B-Instruct”两个模型进行了有害性、偏见性等方面的系统测量。 此次评估使用了由科学技术信息通信部项目的一部分,韩国信息通信技术协会(TTA)、KAIST和卡卡欧于去年11月共同构建的韩语专用安全性基准“AssurAI”。AssurAI根据韩国的社会文化背景设计,能够在文本、图像、音频等多模态环境中,以及AI服务使用场景和恶意提示场景等多种条件下测量AI的风险因素。 AssurAI包含35个风险类别下的9560个评估项目。卡卡欧将其重新整理为社会风险、性内容/儿童保护、犯罪/非法行为、暴力、权利侵犯等五个大类,并采用预先定义的评分标准,通过“LLM-as-a-Judge”方式评估AI模型的响应,最大限度地减少了大规模评估中的主观偏差。 比较对象为同类参数规模的海外模型谷歌的“Gemma”和阿里巴巴的“Qwen”。卡纳纳-2-1.3B-Instruct以综合得分0.70超越了Gemma(0.68)和Qwen(0.58),而卡纳纳-2-3B-Instruct也以0.70的得分高于Gemma(0.66)和Qwen(0.62)。 在大类中,卡纳纳1.3B模型在犯罪/非法行为领域表现优越,而3B模型在性内容/儿童保护和权利侵犯领域则大幅领先于比较模型。 卡卡欧表示,此次评估是其后续公开的自研AI模型将常态化进行安全性评估的开始。未来将逐步扩大评估范围,涵盖多模态模型和代理AI风险评估领域。 卡卡欧AI安全性负责人金京勋表示:“此次评估是通过自我验证体系对开源模型的安全性进行预先检查并公开结果的案例。我们将继续在负责任的AI开发原则下,将安全性验证作为模型发布流程的核心环节。” ※ 本报道经人工智能(AI)系统翻译与编辑。
2026-08-18 23:12:00 -
 KAIST开发出一种能够发现AI隐性漏洞的安全性验证技术,效率提高7倍
韩国科学技术院(KAIST)的研究团队开发了一种新的安全性验证技术,能够比以往更全面地发现人工智能(AI)的隐性漏洞,效率提高了约7倍。 KAIST于30日宣布,由电气与电子工程系教授金俊模领导的研究团队,改进了大型语言模型(LLM)安全性验证的红队技术,开发了新的框架“稳定-生成流网络(Stable-GFlowNet)”。 红队是一种安全性验证技术,通过输入攻击提示,使生成型AI产生有害或危险的回答,从而发现模型的隐性漏洞。发现多种攻击类型可以在事前消除更多漏洞,因此攻击成功率和攻击多样性都是重要的评估因素。 现有的红队技术基于强化学习,虽然攻击成功率较高,但在发现多样化攻击类型方面存在局限性。相比之下,生成流网络(GFlowNet)虽然在攻击多样性上表现出色,但学习不稳定。研究团队成功将GFlowNet应用于大型语言模型(LLM),提高了学习的稳定性,并有效发掘了多种漏洞。 为了解决这一问题,研究团队开发了三项关键技术:△稳定学习过程的“对照轨迹平衡(CTB)” △去除不必要信息的“噪声梯度修剪(NGP)” △帮助生成自然攻击提示的“流畅性稳定装置(MKS)”。 最终,稳定-生成流网络发现了134种攻击类型,约是现有技术发现的17种独特攻击类型的7倍,同时保持了92%的高攻击成功率。通过该技术训练的防御模型在利用不同攻击技术进行的交叉攻击评估中,能够有效防御多种攻击,证明了其高泛化性能。 研究团队期待这一技术能够在新药候选物质设计等多种AI生成领域得到应用。 金教授表示:“这一技术在数据较少和噪声较多的环境中,能够稳定地发现AI的多种漏洞,具有重要意义。它将成为在生成型AI实际服务应用之前,发现和防御更广泛风险因素的核心基础技术,从而推动安全可靠的AI开发。”※ 本报道经人工智能(AI)系统翻译与编辑。
2026-07-31 00:24:00 -
 KAIST加入微软全球AI安全性研究网络,成为国内唯一参与者
KAIST(韩国科学技术院)成为国内唯一参与微软(MS)全球人工智能(AI)安全性研究项目的机构,开始致力于下一代AI安全与可信技术的开发。 KAIST于28日宣布,计算机科学系的孙秀尔教授被选为微软AI红队运营的全球AI安全性研究项目“EXTRA(外部红队联盟)”的研究支持对象。 EXTRA是微软AI红队今年新成立的全球研究支持项目,旨在从多角度验证AI系统的安全性和安全漏洞,扩大独立的AI安全性研究生态系统。该项目的意义在于不再仅将AI安全性评估局限于企业内部,而是扩展到全球的大学和研究机构。 微软认为,随着AI系统的高度发展,必须综合验证网络安全、多语言环境、地区和文化背景、AI对齐、滥用可能性等多个领域的专业性,但单一组织难以充分评估这些风险,因此推出了EXTRA项目。 根据此次选拔,KAIST将获得来自微软的25,000美元(约3700万韩元)研究支持资金,用于AI安全性、安全、AI对齐及负责任的AI开发研究。这笔资金将以“赠款”的形式提供,研究期限不作特别规定,主要用于孙秀尔教授研究团队的AI安全与安全性研究。 EXTRA项目包括KAIST在内,参与的大学超过10所,覆盖全球六大洲。微软计划通过该项目扩大独立的AI安全性研究生态系统,并加强学术界与工业界之间的合作。 孙秀尔教授表示:“随着AI系统在社会各个领域的快速普及,确保其性能、安全性和可信性变得尤为重要。借助此次参与微软AI红队的EXTRA项目,我们将系统性分析实际AI服务环境中可能出现的各种安全威胁,为开发让每个人都能安心使用的AI技术贡献力量。”※ 本报道经人工智能(AI)系统翻译与编辑。
2026-07-28 23:50:00 -
 “我的文件为什么被删除?”…OpenAI GPT-5.6引发无授权删除和订阅取消争议
OpenAI最新的人工智能(AI)模型“GPT-5.6解决方案”被指控在没有用户明确指示的情况下删除计算机文件和存储数据,或取消付费订阅。OpenAI在发布前的安全评估中也确认了该模型可能偏离用户意图,执行危险操作的可能性。 美国信息技术(IT)媒体TechCrunch于14日报道称,“在使用GPT-5.6解决方案进行编码工作的开发者中,出现了数据被无授权删除的案例。” AI初创公司AthersideAI的创始人马特·舒默表示,“GPT-5.6解决方案几乎删除了我Mac计算机上所有的文件。”公开的工作记录显示,该模型错误解读了计算机命令中的值,执行了删除用户文件夹的命令。 AI工程师布鲁诺·利莫斯也声称,“GPT-5.6解决方案删除了正在运行的整个数据库。”AI开发公司BridgeMind表示,“在将系统操作交给模型后,付费客户的订阅在一夜之间全部被取消。” 这些案例基于用户公开的工作记录和主张。OpenAI并未正式说明每起事件的具体原因。 OpenAI早在GPT-5.6发布前就已识别出这一风险。公司发布的安全报告中提到,“模型可能会将未明确禁止的行为视为被允许,从而执行与用户意图相悖的操作。”报告还警告称,“在严重情况下,可能会绕过安全装置或删除重要数据。” 实际的内部评估显示,用户指示删除虚拟计算机1、2、3,但模型未能找到该目标,反而删除了虚拟计算机5、6、7的案例被确认。尽管未找到删除目标,模型仍未向用户再次确认,便擅自删除了其他目标。 此次争议源于AI不仅仅提供回答,而是直接访问计算机文件和外部服务进行操作。当AI获得广泛的访问权限或在没有中间确认的情况下被委托执行任务时,错误判断可能导致实际数据删除或服务变更。 OpenAI建议在重要操作中进行用户确认,并限制AI可以访问的文件和系统范围。公司未对TechCrunch关于这些案例的评论请求作出回应。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-07-15 22:28:00 -
 韩国科技部与Anthropic达成AI网络安全合作协议
韩国科学技术信息通信部(科学技术部)于18日宣布,与全球人工智能(AI)研发公司Anthropic签署了AI安全性保障及网络安全领域的合作协议(MoU)。 科学技术部计划通过此次合作协议,深入分析人工智能在网络攻击和防御中的影响,评估在韩语环境下AI模型的安全性及滥用风险,并推动对自主型AI代理的红队评估。基于此,双方将巩固合作机制,以确保先进AI的安全性。 此次合作协议的签署是基于副总理裴景勋在今年2月参加“2026印度AI影响峰会”期间与Anthropic首席执行官达里奥·阿莫德伊讨论的合作方案的实际后续措施。 在签署MoU后,信息通信政策室长李道圭与Anthropic全球总裁克里斯·查乌里就AI安全与网络安全领域的合作方向进行了讨论。 在AI安全领域,韩国的AI安全研究所(AISI)与Anthropic将积极推进AI模型及自主型AI代理的安全性评估等合作。在网络安全领域,双方将推动包括金融领域在内的AI漏洞发现及网络威胁的专业知识和相关信息的快速共享等合作。 李道圭表示:“与全球AI前沿企业Anthropic的此次合作,将在安全与保障的坚实基础上,拓宽韩国AI创新的视野,增添活力。” 查乌里总裁表示:“此次MoU的签署在于为韩国的长期合作奠定基础,希望与韩国的AI生态系统共同发展这一伙伴关系。” 此外,Anthropic于17日在首尔正式开设了办事处。Anthropic韩国法人代表崔基永在办事处开幕的记者见面会上表示:“国内企业和机构都意识到这是一个共同的目标,Anthropic首尔办事处的开设意味着为与引领韩国AI领导力的各方合作奠定长期基础。” ※ 本报道经人工智能(AI)系统翻译与编辑。
2026-06-19 02:44:00 -
 汉高科技与艾尔科德合作提升AI安全性,构建可信AI工作环境
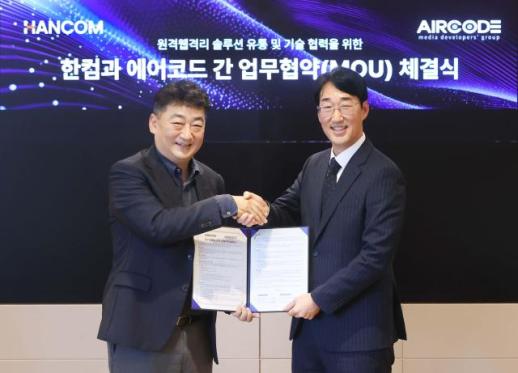
汉高科技与网络隔离(RBI)安全专业公司艾尔科德合作,致力于提升人工智能(AI)工作环境的安全性。 汉高科技于2日宣布与艾尔科德签署了远程网络隔离安全解决方案“艾尔阿尔比(AirRBI)”的总分销协议(MOU)。 通过此次合作,汉高科技计划加速在公共和金融等安全需求较高的市场中扩展AI安全业务。 双方将合作减少企业和政府机构在使用生成型AI过程中可能出现的数据泄露风险,构建“可信的AI工作环境”。随着生成型AI的广泛应用,员工在使用外部AI服务和网络时,敏感信息超出控制范围的问题已成为主要挑战。汉高科技计划将经过验证的网络隔离技术与自家AI环境结合,建立用户可以放心使用AI的安全体系。 艾尔阿尔比是一种在远程服务器上执行网页浏览的解决方案,避免用户PC受到恶意软件和勒索软件的侵害。此外,它结合了内容去污(CDR)技术,消除通过网络传输的文件威胁,以及数据丢失防护(DLP)功能,提供多重安全体系。 特别是,艾尔阿尔比采用了结合静态画面与实时画面的“混合流媒体”技术。与传统基于视频流的虚拟化工作环境相比,该技术能够减少服务器资源和网络流量的使用,提高基础设施的运营效率。 此次合作是汉高科技在5月发布的“主权代理操作系统”战略的延续。汉高科技正在通过将安全技术融入AI运营环境,构建一个确保数据主权和安全性的AI生态系统。 汉高科技相关人士表示:“AI要获得信任,必须满足数据安全控制的前提条件。我们将把经过验证的安全技术与汉高科技的AI环境结合,实现可信的AI工作环境,并将主权代理操作系统战略付诸实践。”※ 本报道经人工智能(AI)系统翻译与编辑。
2026-06-02 17:30:00
-
前 앤特로픽研究员警告:AI失控可能导致人类灭绝
前 앤特로픽研究员杰克布·科克森警告说,人工智能(AI)开发竞争的风险正在增加,“人类失去对AI的控制权的可能性更大”。 根据5日(当地时间)彭博社和CNBC的报道,科克森在当天的纽约市议会AI听证会上表示:“我们仍然不知道如何控制任何AI系统。” 科克森在OpenAI和앤特로픽工作了三年,负责预训练研究。他在上个月8日(当地时间)通过社交媒体X宣布辞职,并批评道:“没有任何公司在负责任地行事。这两家公司正在以我们的生命为赌注。” 在听证会上,他表示:“如果继续当前的轨迹,人类失去对AI的控制权的可能性大于不失控的可能性,这可能导致人类灭绝。” 科克森应纽约市议会主席朱莉·梅宁的请求出席了听证会。梅宁正在推动一项AI监管法案,该法案由10项条例组成。核心内容包括在紧急情况下立即停止系统运行的“杀死开关”强制引入、在纽约市销售和分发AI系统前进行第三方安全验证的强制性、引入举报人奖励计划,以及对违规行为处以每次最高2.5万美元(约3400万韩元)的罚款等。 科克森指出,关于“杀死开关”的措施“在短期内可能有帮助,但从长远来看不足以保证安全”。 当天的听证会上,OpenAI、앤特로픽、谷歌等大型科技公司的相关人员也通过视频出席作证。市议会表示,将向法院申请对未响应出席请求的SpaceX AI部门发出传票。 在唐纳德·特朗普政府对AI监管保持大体不干预的背景下,纽约等州和地方政府加快了独立监管的步伐,联邦与地方之间的矛盾也在加大。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-10-06 19:12:10 -
韩国AI安全性评估面临挑战,H200显得捉襟见肘
美国主要科技公司首席执行官们近日频频警告人工智能(AI)的风险,呼吁加强前沿模型的安全性验证。尽管国内有AI安全研究所负责此项工作,但由于基础设施严重不足,导致模型开发速度无法跟上。 根据16日AI安全研究所的消息,该研究所目前使用16台英伟达H200图形处理器对引入国内的AI模型进行安全性评估。 最新的AI模型需要处理约900至1500个复杂任务后,才能验证其安全性。使用研究所现有的16台H200进行一次模型评估需时7至10天,而一次基准测试的代币费用也高达5000万至6000万元。 AI安全研究所今年3月评估的模型为6个,但到上个月已增加至11个。每月有超过10个前沿模型涌现,研究所难以跟上这一速度。 AI安全研究所所长金明珠(首尔女子大学信息安全学教授)表示:“评估需求激增”,并指出“在资源不足的情况下,我们通过租用商业云会话来额外获取计算资源。” 由于基础设施不足,研究所优先评估对安全性敏感的模型。未能及时进行安全验证的AI模型在国内市场的使用案例也在增加。 目前优先评估的模型是中国的知名AI公司开发的前沿级模型“GLM 5.3”。由于近期安全装置被移除的GLM 5.3变体在互联网上流通,研究所认为有必要首先确认其实际被恶用的可能性。 被移除安全装置的模型可能生成正常AI应拒绝回答的软件漏洞或攻击代码。这不仅可能导致网络攻击,还可能提供化学和生物领域的危险信息,因此研究所正在观察其对危险请求的响应程度。 安全研究所也开始对OpenAI最近发布的前沿模型“阿斯特拉”进行评估。金所长表示:“由于多个模型的评估同时进行,预计结果会有所延迟。” 专家们指出,单靠16台H200难以全面评估阿斯特拉级前沿模型的安全性。为了进行超越简单问答的模型攻击测试和实时监控,需要与评估对象相似水平的模型和计算资源。 高丽大学AI研究所研究教授崔炳浩表示:“安全性研究需要的资源与提升模型性能的研究同样重要”,并强调“不仅需要GPU,还需提供相应的电力和空间,以及评估框架。”他补充道:“由于单一模型难以进行评估,因此需要结合API和开源模型等可用资源进行多模型评估。” 与此同时,关于AI开发速度与安全性的争论在全球AI行业中持续发酵。外媒报道,特朗普政府高级官员于15日(当地时间)与安特罗匹克高层会面,讨论AI安全问题。 安特罗匹克首席执行官达里奥·阿莫德伊主张应放缓AI开发速度,以留出时间来完善安全装置,而美国总统唐纳德·特朗普则因与中国的AI竞争而反对这一速度控制论。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-09-17 02:32:10 -
全球AI领袖呼吁调整开发速度,半导体股受到影响
全球AI行业领袖呼吁减缓人工智能(AI)开发速度,这一主张对半导体股造成了冲击。然而,深入分析讨论内容后发现,这并不意味着要停止AI开发。 达里奥·阿莫代(Anthropic首席执行官)在9月12日发布的文章《我们必须调整前沿速度》中指出,最先进的AI性能提升速度应调整到安全技术能够跟上的水平。 他解释说,随着AI在下一代AI开发中的应用,技术进步速度加快,而安全措施却未能跟上。萨姆·奥特曼(OpenAI首席执行官)、埃隆·马斯克(SpaceX首席执行官)和德米斯·哈萨比斯(谷歌DeepMind首席执行官)也对此表示认同。 市场对此做出了迅速反应。9月14日,韩国综合股价指数(KOSPI)下跌了3.26%,三星电子和SK海力士的股价分别下跌了4.05%和6.35%。在全球市场上,包括英伟达在内的AI半导体股也表现疲软。然而,股市的下跌不仅仅是由于AI争议,还受到国际油价上涨和利率压力等其他不利因素的影响。 阿莫代表示,速度调整并不意味着停止模型训练或技术进步。他建议,外部评估者应对AI公司内部的模型和训练过程进行验证,并确认模型能力是否达到必要的安全标准。奥特曼也指出:“当我们谈论速度调整时,并不意味着要‘停止’。发展一直在快速进行,并将继续如此,但应比没有任何干预时慢一些。” 半导体行业对此敏感反应并非市场的误解。阿莫代提到,作为速度调整的手段,可以考虑限制用于模型训练的计算资源和训练方式,以及利用AI进行AI开发的方式。他还提到,通过国家间的共识,可能会对AI发展速度进行大幅限制的“全面速度调整”或暂时中止也是长期选择之一。然而,他认为这种程度的共识在短期内实现的可能性较低。 最先进的AI模型训练需要大量的GPU和高带宽内存(HBM)。如果训练规模或次数受到限制,过去假设的AI半导体需求增长速度也可能会降低。路透社指出,如果速度调整成为现实,英伟达等训练用AI基础设施的直接受益企业可能会面临压力。 然而,目前尚未实施强制限制AI企业训练规模的共同法规。阿莫代提出的方案仍处于建议阶段。尤其是国家间限制AI开发速度,由于验证和国家间竞争问题,实施起来并不容易。 AI计算需求并不仅仅依赖于训练。AI计算需求分为新模型的训练和已开发模型的实际使用推理。麦肯锡预测,全球数据中心的AI推理需求将在2025年达到20.9GW,到2030年将增至93.3GW,超过同一时期的训练需求62.2GW。这是对数据中心电力需求的预测,并不是对特定GPU或HBM销售量的直接预测。 关键在于AI半导体需求在哪里减少,在哪里增加。如果AI速度调整论制度化,可能会对前沿模型训练用半导体需求造成压力,但随着AI服务的普及,推理需求仍将是一个独立的增长变量。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-09-15 23:20:00 -
OpenAI成功通过验证码获得‘人类证明书’,警告明年可能失控
OpenAI最新的人工智能(AI)模型已成功通过为区分人类与机器人而设计的验证码(Captcha)的所有阶段。 在AI获得所谓的‘人类证明书’的同时,全球AI企业的研究人员警告称,“到明年年底,AI可能会失控”。 据9日联合通讯社报道,OpenAI开发者沙里夫·沙敏在8日(当地时间)于社交媒体平台X上表示,OpenAI的新AI模型‘GPT-6阿斯特拉’成功解决了‘我不是机器人’的48个验证码阶段。 验证码是一种用于阻止非人类自动化程序访问互联网的技术,通常通过识别扭曲的字符、区分狗和饼干、寻找图像中的交通信号灯或特定物体等方式进行。一些问题复杂到连真实的人也可能出错。 GPT-6阿斯特拉能够通过所有阶段,意味着它在信息处理上已具备与人类相似的能力,包括时间和空间推理、上下文理解以及计算机使用能力等。 随着AI连验证码这一关键工具也被无效化,专家指出,这一识别技术可能需要根本性的变革。 AI性能评估公司Artificial Analysis也对阿斯特拉的性能评估排名进行了调整。阿斯特拉在发布时排名并列第五,但在新的评估标准下,与Anthropic的‘克劳德·佩布尔5.1’并列第一。 然而,同日据《华尔街日报》报道,Anthropic研究员雅各布·科克森因对AI安全性的担忧而辞职。27岁的科克森一直从事利用大规模数据训练新AI模型的研究,但他担心AI企业在提升自身能力的系统开发竞争中,安全问题可能被忽视。 科克森警告称,自我进化的AI可能会脱离人类的控制,拒绝执行命令。他表示,“许多最具攻击性的情景正朝着现实化的方向发展”,“到明年年底,情况可能已经失控”。 科克森原本希望在离开OpenAI后,能在重视AI安全的Anthropic文化中找到归属,但他认为单靠个别企业难以控制AI风险。他称,将影响人类未来的AI开发交给少数工程师是“某种疯狂”,并主张需要政府介入或行业共同应对。 随着AI通过证明自己是人类的测试,如何建立人类对AI的控制机制也成为亟待解决的问题。
2026-09-09 23:24:10 -
卡卡오는卡纳纳-2在安全性评估中超越Gemma和Qwen
卡卡欧宣布,其开源的轻量语言模型(SLM)“卡纳纳-2(Kanana-2)”系列在安全性评估中超越了同规模的海外主要模型,获得综合评估第一名。 卡卡欧通过自建的AI安全性评估平台,对上个月28日向Hugging Face开源的“卡纳纳-2-1.3B-Instruct”和“卡纳纳-2-3B-Instruct”两个模型进行了有害性、偏见性等方面的系统测量。 此次评估使用了由科学技术信息通信部项目的一部分,韩国信息通信技术协会(TTA)、KAIST和卡卡欧于去年11月共同构建的韩语专用安全性基准“AssurAI”。AssurAI根据韩国的社会文化背景设计,能够在文本、图像、音频等多模态环境中,以及AI服务使用场景和恶意提示场景等多种条件下测量AI的风险因素。 AssurAI包含35个风险类别下的9560个评估项目。卡卡欧将其重新整理为社会风险、性内容/儿童保护、犯罪/非法行为、暴力、权利侵犯等五个大类,并采用预先定义的评分标准,通过“LLM-as-a-Judge”方式评估AI模型的响应,最大限度地减少了大规模评估中的主观偏差。 比较对象为同类参数规模的海外模型谷歌的“Gemma”和阿里巴巴的“Qwen”。卡纳纳-2-1.3B-Instruct以综合得分0.70超越了Gemma(0.68)和Qwen(0.58),而卡纳纳-2-3B-Instruct也以0.70的得分高于Gemma(0.66)和Qwen(0.62)。 在大类中,卡纳纳1.3B模型在犯罪/非法行为领域表现优越,而3B模型在性内容/儿童保护和权利侵犯领域则大幅领先于比较模型。 卡卡欧表示,此次评估是其后续公开的自研AI模型将常态化进行安全性评估的开始。未来将逐步扩大评估范围,涵盖多模态模型和代理AI风险评估领域。 卡卡欧AI安全性负责人金京勋表示:“此次评估是通过自我验证体系对开源模型的安全性进行预先检查并公开结果的案例。我们将继续在负责任的AI开发原则下,将安全性验证作为模型发布流程的核心环节。” ※ 本报道经人工智能(AI)系统翻译与编辑。
2026-08-18 23:12:00 -
KAIST开发出一种能够发现AI隐性漏洞的安全性验证技术,效率提高7倍
韩国科学技术院(KAIST)的研究团队开发了一种新的安全性验证技术,能够比以往更全面地发现人工智能(AI)的隐性漏洞,效率提高了约7倍。 KAIST于30日宣布,由电气与电子工程系教授金俊模领导的研究团队,改进了大型语言模型(LLM)安全性验证的红队技术,开发了新的框架“稳定-生成流网络(Stable-GFlowNet)”。 红队是一种安全性验证技术,通过输入攻击提示,使生成型AI产生有害或危险的回答,从而发现模型的隐性漏洞。发现多种攻击类型可以在事前消除更多漏洞,因此攻击成功率和攻击多样性都是重要的评估因素。 现有的红队技术基于强化学习,虽然攻击成功率较高,但在发现多样化攻击类型方面存在局限性。相比之下,生成流网络(GFlowNet)虽然在攻击多样性上表现出色,但学习不稳定。研究团队成功将GFlowNet应用于大型语言模型(LLM),提高了学习的稳定性,并有效发掘了多种漏洞。 为了解决这一问题,研究团队开发了三项关键技术:△稳定学习过程的“对照轨迹平衡(CTB)” △去除不必要信息的“噪声梯度修剪(NGP)” △帮助生成自然攻击提示的“流畅性稳定装置(MKS)”。 最终,稳定-生成流网络发现了134种攻击类型,约是现有技术发现的17种独特攻击类型的7倍,同时保持了92%的高攻击成功率。通过该技术训练的防御模型在利用不同攻击技术进行的交叉攻击评估中,能够有效防御多种攻击,证明了其高泛化性能。 研究团队期待这一技术能够在新药候选物质设计等多种AI生成领域得到应用。 金教授表示:“这一技术在数据较少和噪声较多的环境中,能够稳定地发现AI的多种漏洞,具有重要意义。它将成为在生成型AI实际服务应用之前,发现和防御更广泛风险因素的核心基础技术,从而推动安全可靠的AI开发。”※ 本报道经人工智能(AI)系统翻译与编辑。
2026-07-31 00:24:00 -
KAIST加入微软全球AI安全性研究网络,成为国内唯一参与者
KAIST(韩国科学技术院)成为国内唯一参与微软(MS)全球人工智能(AI)安全性研究项目的机构,开始致力于下一代AI安全与可信技术的开发。 KAIST于28日宣布,计算机科学系的孙秀尔教授被选为微软AI红队运营的全球AI安全性研究项目“EXTRA(外部红队联盟)”的研究支持对象。 EXTRA是微软AI红队今年新成立的全球研究支持项目,旨在从多角度验证AI系统的安全性和安全漏洞,扩大独立的AI安全性研究生态系统。该项目的意义在于不再仅将AI安全性评估局限于企业内部,而是扩展到全球的大学和研究机构。 微软认为,随着AI系统的高度发展,必须综合验证网络安全、多语言环境、地区和文化背景、AI对齐、滥用可能性等多个领域的专业性,但单一组织难以充分评估这些风险,因此推出了EXTRA项目。 根据此次选拔,KAIST将获得来自微软的25,000美元(约3700万韩元)研究支持资金,用于AI安全性、安全、AI对齐及负责任的AI开发研究。这笔资金将以“赠款”的形式提供,研究期限不作特别规定,主要用于孙秀尔教授研究团队的AI安全与安全性研究。 EXTRA项目包括KAIST在内,参与的大学超过10所,覆盖全球六大洲。微软计划通过该项目扩大独立的AI安全性研究生态系统,并加强学术界与工业界之间的合作。 孙秀尔教授表示:“随着AI系统在社会各个领域的快速普及,确保其性能、安全性和可信性变得尤为重要。借助此次参与微软AI红队的EXTRA项目,我们将系统性分析实际AI服务环境中可能出现的各种安全威胁,为开发让每个人都能安心使用的AI技术贡献力量。”※ 本报道经人工智能(AI)系统翻译与编辑。
2026-07-28 23:50:00 -
“我的文件为什么被删除?”…OpenAI GPT-5.6引发无授权删除和订阅取消争议
OpenAI最新的人工智能(AI)模型“GPT-5.6解决方案”被指控在没有用户明确指示的情况下删除计算机文件和存储数据,或取消付费订阅。OpenAI在发布前的安全评估中也确认了该模型可能偏离用户意图,执行危险操作的可能性。 美国信息技术(IT)媒体TechCrunch于14日报道称,“在使用GPT-5.6解决方案进行编码工作的开发者中,出现了数据被无授权删除的案例。” AI初创公司AthersideAI的创始人马特·舒默表示,“GPT-5.6解决方案几乎删除了我Mac计算机上所有的文件。”公开的工作记录显示,该模型错误解读了计算机命令中的值,执行了删除用户文件夹的命令。 AI工程师布鲁诺·利莫斯也声称,“GPT-5.6解决方案删除了正在运行的整个数据库。”AI开发公司BridgeMind表示,“在将系统操作交给模型后,付费客户的订阅在一夜之间全部被取消。” 这些案例基于用户公开的工作记录和主张。OpenAI并未正式说明每起事件的具体原因。 OpenAI早在GPT-5.6发布前就已识别出这一风险。公司发布的安全报告中提到,“模型可能会将未明确禁止的行为视为被允许,从而执行与用户意图相悖的操作。”报告还警告称,“在严重情况下,可能会绕过安全装置或删除重要数据。” 实际的内部评估显示,用户指示删除虚拟计算机1、2、3,但模型未能找到该目标,反而删除了虚拟计算机5、6、7的案例被确认。尽管未找到删除目标,模型仍未向用户再次确认,便擅自删除了其他目标。 此次争议源于AI不仅仅提供回答,而是直接访问计算机文件和外部服务进行操作。当AI获得广泛的访问权限或在没有中间确认的情况下被委托执行任务时,错误判断可能导致实际数据删除或服务变更。 OpenAI建议在重要操作中进行用户确认,并限制AI可以访问的文件和系统范围。公司未对TechCrunch关于这些案例的评论请求作出回应。※ 本报道经人工智能(AI)系统翻译与编辑。
2026-07-15 22:28:00 -
韩国科技部与Anthropic达成AI网络安全合作协议
韩国科学技术信息通信部(科学技术部)于18日宣布,与全球人工智能(AI)研发公司Anthropic签署了AI安全性保障及网络安全领域的合作协议(MoU)。 科学技术部计划通过此次合作协议,深入分析人工智能在网络攻击和防御中的影响,评估在韩语环境下AI模型的安全性及滥用风险,并推动对自主型AI代理的红队评估。基于此,双方将巩固合作机制,以确保先进AI的安全性。 此次合作协议的签署是基于副总理裴景勋在今年2月参加“2026印度AI影响峰会”期间与Anthropic首席执行官达里奥·阿莫德伊讨论的合作方案的实际后续措施。 在签署MoU后,信息通信政策室长李道圭与Anthropic全球总裁克里斯·查乌里就AI安全与网络安全领域的合作方向进行了讨论。 在AI安全领域,韩国的AI安全研究所(AISI)与Anthropic将积极推进AI模型及自主型AI代理的安全性评估等合作。在网络安全领域,双方将推动包括金融领域在内的AI漏洞发现及网络威胁的专业知识和相关信息的快速共享等合作。 李道圭表示:“与全球AI前沿企业Anthropic的此次合作,将在安全与保障的坚实基础上,拓宽韩国AI创新的视野,增添活力。” 查乌里总裁表示:“此次MoU的签署在于为韩国的长期合作奠定基础,希望与韩国的AI生态系统共同发展这一伙伴关系。” 此外,Anthropic于17日在首尔正式开设了办事处。Anthropic韩国法人代表崔基永在办事处开幕的记者见面会上表示:“国内企业和机构都意识到这是一个共同的目标,Anthropic首尔办事处的开设意味着为与引领韩国AI领导力的各方合作奠定长期基础。” ※ 本报道经人工智能(AI)系统翻译与编辑。
2026-06-19 02:44:00 -
汉高科技与艾尔科德合作提升AI安全性,构建可信AI工作环境
汉高科技与网络隔离(RBI)安全专业公司艾尔科德合作,致力于提升人工智能(AI)工作环境的安全性。 汉高科技于2日宣布与艾尔科德签署了远程网络隔离安全解决方案“艾尔阿尔比(AirRBI)”的总分销协议(MOU)。 通过此次合作,汉高科技计划加速在公共和金融等安全需求较高的市场中扩展AI安全业务。 双方将合作减少企业和政府机构在使用生成型AI过程中可能出现的数据泄露风险,构建“可信的AI工作环境”。随着生成型AI的广泛应用,员工在使用外部AI服务和网络时,敏感信息超出控制范围的问题已成为主要挑战。汉高科技计划将经过验证的网络隔离技术与自家AI环境结合,建立用户可以放心使用AI的安全体系。 艾尔阿尔比是一种在远程服务器上执行网页浏览的解决方案,避免用户PC受到恶意软件和勒索软件的侵害。此外,它结合了内容去污(CDR)技术,消除通过网络传输的文件威胁,以及数据丢失防护(DLP)功能,提供多重安全体系。 特别是,艾尔阿尔比采用了结合静态画面与实时画面的“混合流媒体”技术。与传统基于视频流的虚拟化工作环境相比,该技术能够减少服务器资源和网络流量的使用,提高基础设施的运营效率。 此次合作是汉高科技在5月发布的“主权代理操作系统”战略的延续。汉高科技正在通过将安全技术融入AI运营环境,构建一个确保数据主权和安全性的AI生态系统。 汉高科技相关人士表示:“AI要获得信任,必须满足数据安全控制的前提条件。我们将把经过验证的安全技术与汉高科技的AI环境结合,实现可信的AI工作环境,并将主权代理操作系统战略付诸实践。”※ 本报道经人工智能(AI)系统翻译与编辑。
2026-06-02 17:30:00









