
超过3800万条数据,包括书籍、表格、插图、广告和照片,将向全国公众开放。
国立中央图书馆于17日宣布,首次向公众开放国家文献中构建的人工智能(AI)学习数据。
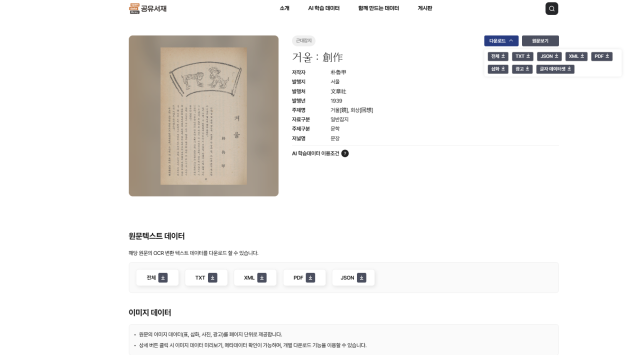
公开的数据包括3974本书的文本数据(Hidden Text PDF、XML、TXT、JSON)、2万1485条表格、插图、广告、照片等图像数据、元数据和3830万条字符数据集,总计达到3833万条。
此次数据开放伴随着“共享书库”平台的改版,使其更适合AI学习数据的使用。此次改版的重点是增强便利性,以便任何人都能轻松使用,适用于AI学习、学术研究、服务和应用开发、内容制作等多种目的。
文本数据以易于AI识别的高质量形式提供,能够直接用于研究和服务开发。字符数据集可以直接用于AI学习的各种形式的字符数据,预计将帮助面临大规模数据获取困难的中小企业和创业公司广泛应用于AI基础的文字识别(OCR)和自然语言处理等相关技术开发。
改版后的“共享书库”还增强了对AI和数字人文学科研究的支持功能,扩展了公共数据的利用。通过将数字化积累的大量知识资料整理和加工为AI可以学习的形式,原本难以进行的大规模数据基础的人文学科研究变得可能。研究人员可以更轻松地利用AI分析文献、记录、图像等多种资料,提取新的意义,进行数字人文学科研究。
此外,能够以适合AI学习的形式大规模开放版权问题已解决的国家文献,具有重要意义。这将减轻长期以来在获取学习数据时面临的成本和版权负担,尤其是对研究人员和中小企业的影响。
平台的用户环境也进行了用户友好的改进。采用直观的界面设计和按资料类型及图像类型的探索结构,任何人都可以轻松访问数据,无需额外注册程序,使专业研究人员和普通用户都能方便地搜索和利用资料。
国立中央图书馆计划在今年年底再开放300余本韩文小说的文本数据,并将持续扩大数据的构建和开放,提升AI应用服务,发展“共享书库”成为一个持续成长的数据平台。
国立中央图书馆数字信息规划科科长李贤珠表示:“我们将持续扩大数据开放范围,建设一个让每位国民都能享受公共知识资源的AI时代图书馆。”
※ 本报道经人工智能(AI)系统翻译与编辑。












